はじめに
分身のキャラクターが日本の実在の鉄道路線を勝手に旅して、途中下車した駅の名物や車窓の風景を一人称の日記に書いて届けてくれる、というWebサービスを作って公開しました。
bunshin-tabi.com
企画からデータ処理、日記の生成、OGP画像、独自ドメインでの公開まで、ほぼすべてを Claude Code と対話しながら作りました。いわゆる「操作する旅」ではなく、旅かえるのように「分身が勝手にした旅の報告を受け取る」非同期の体験を狙っています。
技術的には、駅データ.jpのCSV、OpenStreetMapの実線形、Wikipediaの沿線情報、OpenAIの日記生成、Cloudflare Workersの静的配信、GitHub Actionsの夜間バッチ、といった無料〜低コストの部品を組み合わせただけです。ただ、実際に組み立てると「駅の座標はあるが線路の形がない」「LLMが日記を途中でやめる」「PWAのService Workerが全ページを真っ白にする」といった、地味だが必ずつまずくポイントがいくつもありました。そのあたりも含めて、作った順番で書いていきます。
分身の旅日記とは
コンセプトはシンプルです。
- 分身(名前・絵文字・性格を持ったキャラ)が、日本の実在の鉄道路線を1本旅する
- 途中下車した駅では長めの日記、通過する駅では車窓からの短い一言を書く
- 沿線の実在スポット(名物・史跡・河川・橋梁・廃線跡など)を固有名詞で織り込む
- 毎朝1本、全ユーザーが同じ「便」を読む新聞連載のような形で配信する
- 旅した路線は日本地図に蓄積され、どこまで旅したかが一目で分かる
ポイントは「実在」であることです。架空の路線ではなく、駅の座標も線路の形も実データを使う。日記に出てくる橋や川や名物も、Wikipediaに載っている本物を使う。この具体性があると、単なる自動生成テキストが「どこか本当にありそうな旅」に見えてきます。
同じ路線でも、性格の違う分身が旅すると「何に目を留めるか」が変わって別の旅になります。廃線と橋梁が好きな無口な猫(絵文字は🐈⬛)と、食べ物と古い街並みに弱いのんびり屋では、同じ駅を通っても書く内容がまるで違う。ここが生成AIらしい面白さでした。
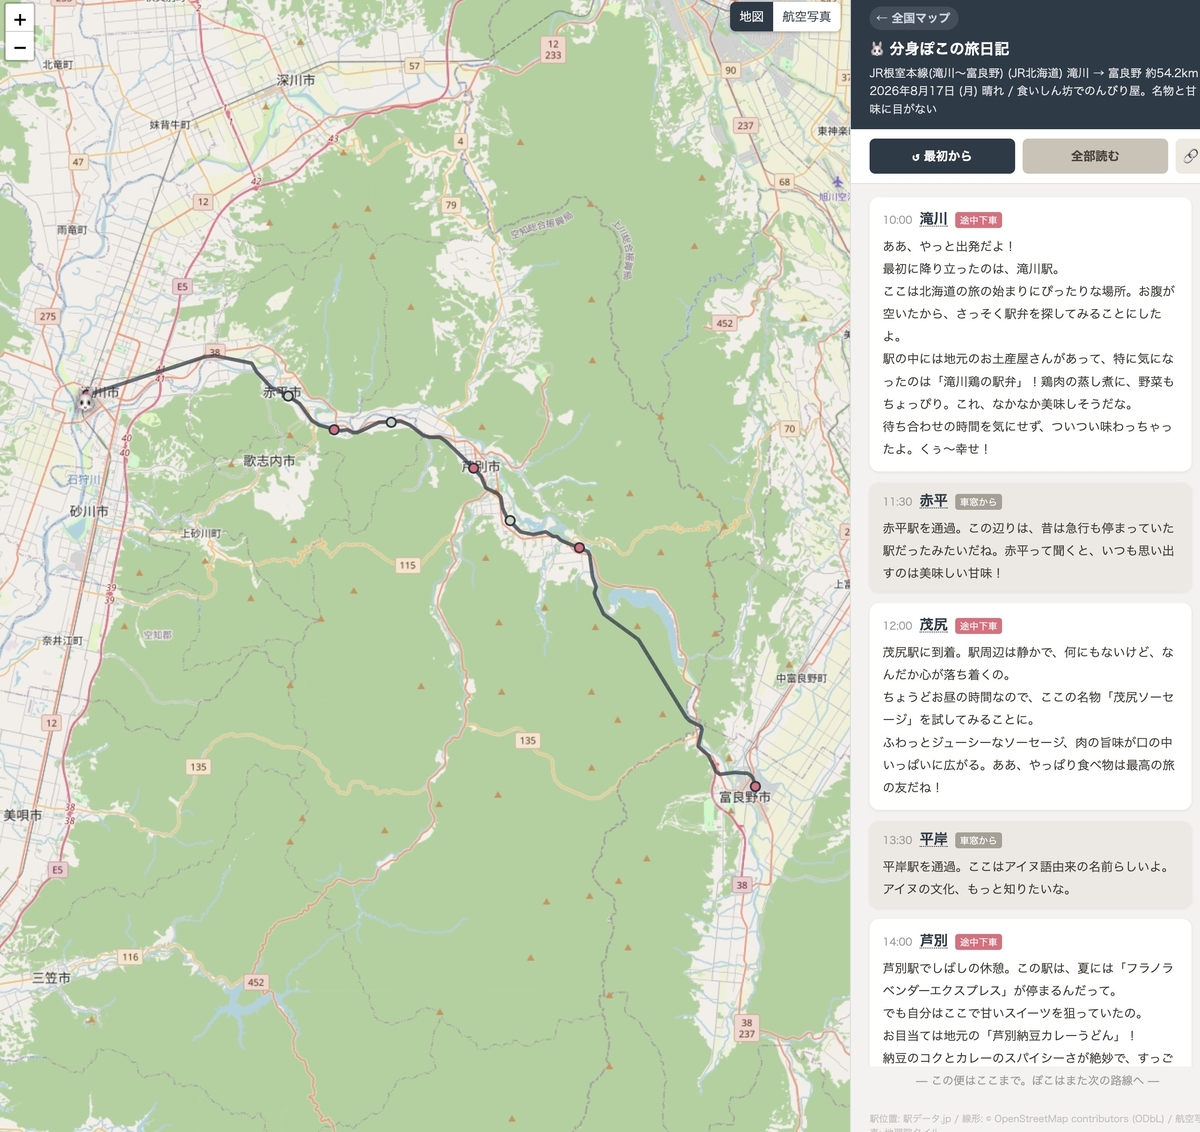
実際の画面はこんな見た目です。左に地図と分身のマーカー、右に日記のフィードが並び、「旅を再生」すると分身が線形の上を動きながら、日記が時系列で現れます。カードをクリックすると地図がその地点にジャンプします。
全体像: 認証もDBもない静的サイト
v1では、あえて認証もデータベースも持たせませんでした。全員が同じ便を読むので、ユーザーごとの状態が要らない。だから構成は次のように振り切れます。
- 配信:
trips/<日付>.json を静的ファイルとして置くだけ
- 生成: 夜間バッチを1本回して、翌朝の便のJSONを作る
データの流れはこうです。
- 路線を選ぶ(日付をシードに決定的に選定)
- その路線の実線形をOpenStreetMapから取得(路線ごとに一度取ればキャッシュできる)
- 沿線スポットをWikipediaから集める
- ペルソナ + 路線 + スポットをプロンプトに渡してOpenAIで日記を生成
- trip JSONに保存して静的配信
配信はCloudflare Workers(静的アセット)、夜間バッチはGitHub Actionsのcronにしました。どちらも無料枠で収まります。ランニングコストで意味があるのは、実質OpenAIのAPI呼び出し(1便あたり1回)だけです。
駅はあるが線路がない: 実線形をどう取るか
最初のハマりどころがここでした。駅データ.jpの無料CSVには全国約1万駅の座標が入っていて、路線ごとに駅を並べることはできます。ただし、駅と駅を結ぶ「線路の形」は入っていません。駅を直線でつなぐと、カーブの多いローカル線はまるで別物になってしまいます。
そこでOpenStreetMapのOverpass APIから実際の線路の形を取ります。路線名で問い合わせるのですが、これが素直にいきません。
- route relationがある路線とない路線がある(名松線にはなかった)
- OSM上の路線名は表記ゆれがある(「南海電気鉄道加太線」のように事業者名付きだったり)
- 他の路線と線路を共有する区間がある(加太線の和歌山市〜紀ノ川は南海本線を走る)
なので、relationを試してダメならway検索にフォールバックし、路線名は正規表現の部分一致で拾います。
[out:json][timeout:60];
relation["route"="train"]["name"~"加太線"];
out geom;
共用区間が厄介でした。路線名だけで引くと、共有している区間の線路が欠けて駅がつながりません。ここは、取得したway群の全頂点をノードとするグラフを作り、起点駅から終点駅までをダイクストラ法で最短経路探索する方式にしました。bbox指定で周辺の全路線の線路を集め、最大連結成分の中で起点・終点に最も近いノードを選んでから探索します。
取れた線形は、そのままだと点が多すぎるのでDouglas-Peuckerで200点前後に間引きます。環状線は始点=終点で退化するので、2分割してから間引く必要がありました。
正しく取れたかは、生成AIには任せず機械的に検証します。
- 各駅を線形上に垂線射影して弧長を求め、駅の並び順で弧長が単調増加すること
- 駅と線形の距離が数十m以内であること
- 総延長が実路線長とほぼ一致すること
この3点で自動判定させました。実際に加太線を通したところ、共用区間を含めて12.1kmが得られ、実路線の12.0kmとほぼ一致しました。山手線34.5km、名松線43.5kmも実測とほぼ合致。線形の検証を機械化しておくと、路線を増やしたときに「なんか変な形になっている」を人手で見なくて済みます。
新幹線・地下鉄・ケーブルカーなどは旅の対象から外し、最終的に旅できる路線は537本になりました。
沿線スポットを集めて日記を書かせる
線形が取れたら、次は日記の材料です。ここの質で日記の面白さが決まります。定型文っぽくなると一気に冷めるので、実在の固有名詞をどれだけ織り込めるかが勝負でした。
材料はWikipediaのMediaWiki APIから、路線記事と各駅記事のイントロを抜き出して集めます。これをペルソナ定義(名前・性格・興味の対象・文体)と一緒にプロンプトへ渡し、OpenAIに日記の配列を書かせます。
出力の形は、構造化出力(response_format の json_schema strictモード)で固定しました。各エントリは時刻・駅インデックス・種別(stop/pass)・本文HTMLという形です。
const body = {
  model: "gpt-4o-mini",
  messages: [
    { role: "system", content: system },
    { role: "user", content: user },
  ],
  response_format: {
    type: "json_schema",
    json_schema: { name: "diary", strict: true, schema: DIARY_SCHEMA },
  },
  max_completion_tokens: 12000,
};
これで、パースに失敗しない安定したJSONが返ってきます。固有名詞にはWikipediaや検索へのaタグを本文に埋め込ませ、「事実の捏造をしない。自信がないスポットは書かない」というルールもプロンプトで縛りました。
日記が途中の駅で止まる
公開後、7駅ある路線なのに日記が2駅目で終わっている便を見つけました。終点まで旅せずに、途中でぷつっと切れている。gpt-4o-miniが「全駅をたどって終点まで書く」という指示を守り切れず、短い出力で満足してしまったのが原因でした。
ここが生成AIを組み込むときの典型的なハマりどころだと思います。プロンプトで指示しても、モデルが弱いと平気で途中でやめる。そこで、プロンプトを強くするだけでなく、生成結果を検証して未達ならリトライする仕組みを足しました。
function isComplete(diary, stationCount) {
if (!diary || diary.length < Math.max(3, Math.ceil(stationCount * 0.6))) return false;
const maxSt = Math.max(...diary.map((e) => e.st));
if (maxSt < stationCount - 1) return false;
if (!diary.some((e) => e.st === 0)) return false;
return true;
}
終点に到達しているか、駅数に対して十分な件数か、起点があるかを見て、満たさなければ最大3回まで、より強い指示を添えて作り直します。プロンプトだけに頼らず、出力を機械で検証して駄目なら回す。この一手間で、モデルの気まぐれに振り回されにくくなりました。
品質をもう一段上げたいときは、OPENAI_MODEL を gpt-4o に切り替えれば指示追従が明確に良くなります。ここはコストとの相談で、環境変数一つで動かせるようにしてあります。
SNSで映えるOGP画像を動的に作る
拡散はSNS共有が頼りなので、リンクを貼ったときのカードにこだわりました。便ごとに、その路線の実際の形をそのまま絵にしたOGP画像(1200×630のPNG)を生成しています。
ここで二つ、地味だが重要な壁がありました。
一つ目は、SNSのクローラはJavaScriptを実行せずにHTMLの <head> しか読まない、という点です。SPAのままだと全ページ同じOGPになってしまう。なので、ビルド時に便ごとの実HTMLを生成し、og:title や og:image を焼き込んでおく必要があります。
二つ目は、画像内に日本語を描くために日本語フォントが要る、という点です。PNG化には @resvg/resvg-wasm を使いました。ネイティブ依存がなく、Cloudflareのビルド環境でもそのまま動くのが決め手です。
import { Resvg, initWasm } from "@resvg/resvg-wasm";

await initWasm(readFileSync("node_modules/@resvg/resvg-wasm/index_bg.wasm"));
const r = new Resvg(svg, {
  font: { fontBuffers: [fontBuffer], defaultFontFamily: "Noto Sans JP", loadSystemFonts: false },
  fitTo: { mode: "width", value: 1200 },
});
writeFileSync(out, r.render().asPng());
ここでもう一つつまずきました。Noto Sans JPのバリアブルフォントをそのまま渡すと、SVGで font-weight: 700 を指定しても細いウェイトで描画されてしまう。文字が細くて薄い、と指摘を受けて気づきました。resvgがバリアブルフォントのウェイト軸を効かせてくれないようです。
対処は、fonttoolsでバリアブルフォントを太字ウェイトに固定した静的インスタンスを作り、それを渡すことでした。
python3 -m fontTools.varLib.instancer "NotoSansJP[wght].ttf" wght=700 -o NotoSansJP-Bold.ttf
これで路線名も駅名もしっかり太字で描画されるようになりました。実際に生成されるカードはこんな見た目です。山手線ならあのループの形が、そのまま画像になります。

画像生成は依存インストールが絡んで壊れやすいので、動的importとtry/catchで囲み、失敗してもサイトのビルド自体は止まらないようにしてあります。
全ページが真っ白: Service Workerの罠
公開して少し経ってから、「他の旅を選んでも表示されない」「リンクを開くとERR_FAILED」という報告が来ました。トップから個別の旅に遷移すると、ページが真っ白になる。
原因はPWA用に入れていたService Workerでした。ナビゲーション時にキャッシュした /index.html を返す実装だったのですが、Cloudflareの静的アセット配信では /index.html がリダイレクト扱いになるため、それをキャッシュから返すと空のページになってしまう。初回の直リンクだけはService Workerが制御する前なので動き、以降のナビゲーションが壊れる、という分かりにくい壊れ方でした。
ここは判断として、v1ではオフライン機能よりも確実性を優先し、Service Workerを廃止しました。ただ、すでに壊れたSWを持ってしまったブラウザを放置できないので、新しいSWを「キルスイッチ」にして、起動時に全キャッシュを削除して自身をunregisterし、開いているタブを再読込させるようにしました。
self.addEventListener("activate", (event) => {
  event.waitUntil((async () => {
    const keys = await caches.keys();
    await Promise.all(keys.map((k) => caches.delete(k)));
    await self.registration.unregister();
    const clients = await self.clients.matchAll({ type: "window" });
    for (const client of clients) client.navigate(client.url);
  })());
});
これをデプロイすると、壊れたSWを持つブラウザも次のアクセスで自動的に回復しました。よかれと思って入れたキャッシュ機構が体験を壊す、というのはPWAでありがちな事故だと思います。オフライン対応が必須でないなら、無理に入れない方が安全でした。
トップは「日本が埋まっていく」地図に
便が増えていく蓄積型のサービスなので、トップページには全国カバレッジマップを置きました。これまで旅した全路線を日本地図にプロットし、便が増えるほど日本が線で埋まっていくのが見えるようにしています。
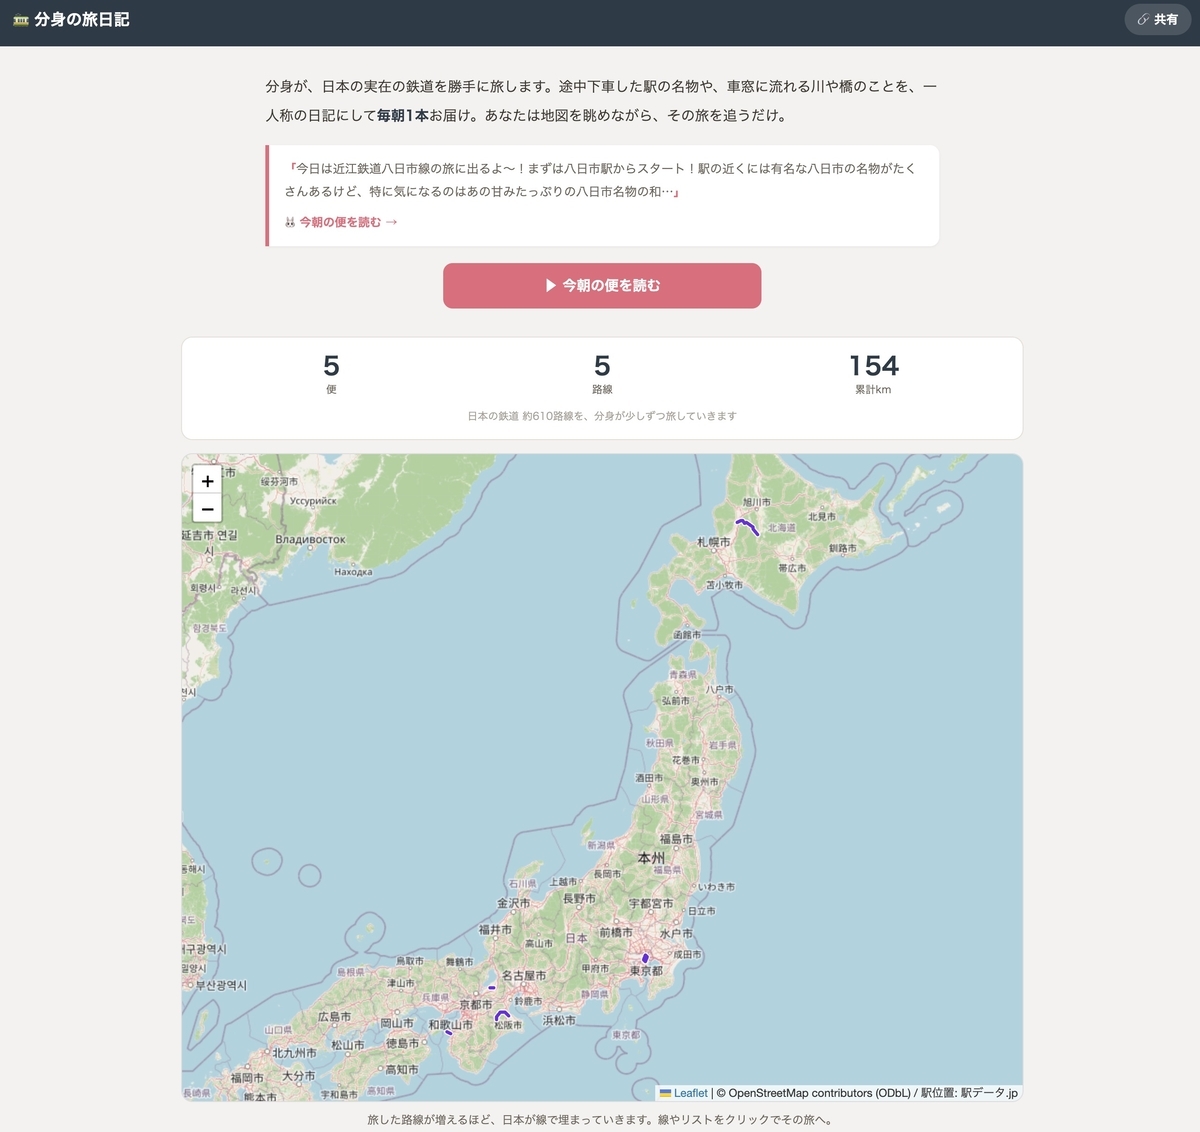
最初は路線の線を赤系にしていたのですが、OpenStreetMapの地図は道路も鉄道も赤やピンクなので紛れてしまう。濃い紫にして、さらに白いふち(ケーシング)を敷くことで、背景に関係なく浮いて見えるようにしました。地図上に自前の線を重ねるときの定番テクニックです。
また、地図と統計だけだと「これが何のサイトか」が初見では伝わらないので、コンセプトの説明文と、その日の日記の冒頭を引用する「今朝の一節」を足しました。読む前の味見があると、地図だけでは出せない読み物としての引力が出ます。
公開: Cloudflare Workers + 独自ドメイン
配信はCloudflare Workersの静的アセットにしました。wrangler.jsonc で not_found_handling を single-page-application にしておくと、実ファイルのないパスには index.html を返してくれます。便ごとの実HTMLは実ファイルとして置いてあるので、そちらが優先され、OGPメタも正しく配信されます。
GitHub Actionsの夜間バッチは、毎日日本時間の朝4時に翌朝の便を生成してコミットし、pushをトリガーにCloudflareが自動で再デプロイします。生成に必要なOpenAIキーはリポジトリのSecretに置くので、手元に鍵がなくても運用が回ります。
最後に独自ドメイン bunshin-tabi.com を取りました。OGP画像や共有リンクのURLは環境変数 SITE_URL 一つで切り替わるようにしてあったので、ドメインを繋いでからその値を差し替えるだけで、カードもリンクも一斉に新ドメインへ移りました。
法務面も先に確認しています。駅データ.jpは商用利用・加工利用ともにOK、OpenStreetMapはODbLで「© OpenStreetMap contributors」の表記を維持、地理院タイルは出典表記を維持。これらはサイトのクレジット表記で明示しています。
まとめ
分身の旅日記をゼロから作って公開してみて分かったことをまとめます。
- 駅の座標はオープンデータで手に入るが、線路の形はOSMから別途取る必要がある。共用区間はグラフ + ダイクストラで解くのが確実
- 線形が正しいかは生成AIに判断させず、弧長の単調増加・駅との距離・総延長で機械的に検証すると、路線を増やしても破綻に気づける
- LLMは指示しても途中で仕事をやめることがある。出力を検証して未達ならリトライする仕組みを一枚かませると安定する
- OGPは、SNSクローラがJSを読まないので便ごとの実HTMLにメタを焼き込む必要がある。画像内の日本語はバリアブルフォントを静的ウェイトに固定してから描く
- PWAのService Workerは、よかれと思って入れると全ページを壊すことがある。オフラインが必須でないなら無理に入れない
- 静的配信 + 夜間バッチ + LLM 1コールという構成なら、認証もDBもなしで、ほぼ無料枠で個人サービスとして公開まで持っていける
一番の収穫は、生成AIを組み込むほど「AIに任せない部分」の設計が効いてくる、と実感できたことでした。線形の検証も、日記の完全性チェックも、やっているのはただの機械的な判定です。生成の面白さは残しつつ、破綻しうるところは古典的なコードで押さえる。この役割分担がうまくいくと、毎朝ひとりでに旅が増えていくサービスが、手を離しても回るようになりました。
まだ数便しかありませんが、蓄積型のサービスなので本番は数週間後です。日本地図が線で埋まっていくのを、のんびり眺めようと思います。
参考リンク